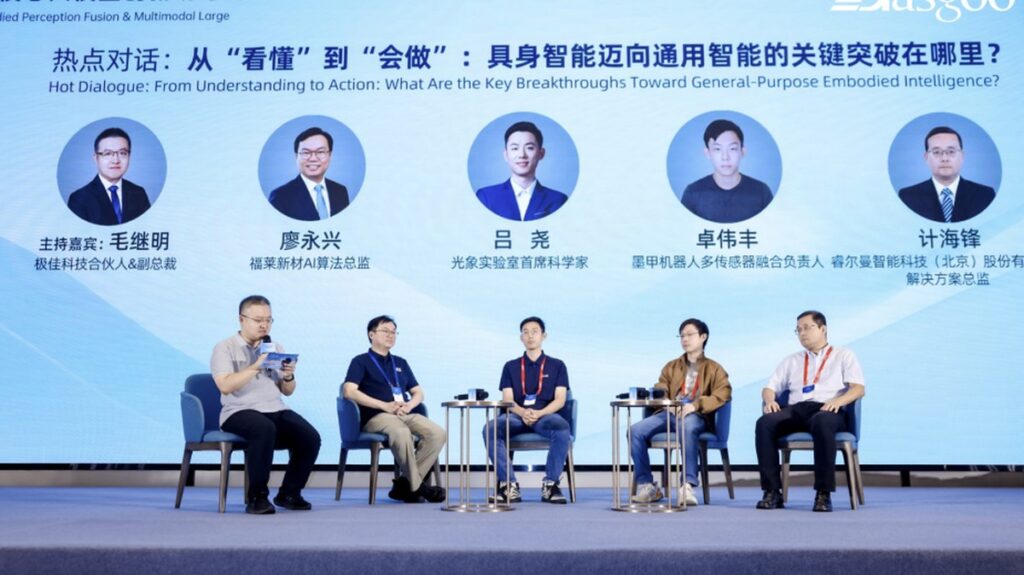
Endüstride otonom sürüş ve robotik alanının en çarpıcı tartışması, “gömülü zeka” denilen bu beynin nasıl tasarlanması gerektiği üzerine yoğunlaştı. Pekin merkezli Gasgoo Grubu’nun düzenlediği “2026 Gömülü Algı Füzyonu ve Çok Modlu Büyük Model İnovasyon Sempozyumu”nda bir araya gelen sektörün önde gelen uzmanları, VLA (Görüntü-Dil-Eylem) modellerinin yerini dünya modellerinin alıp almayacağı sorusunu masaya yatırdı. Katılımcılar, tartışmanın artık “bu teknoloji var mı?” aşamasını geride bırakıp “hangi çözüm daha üstün?” sorusuna geçtiğini vurguladı.
Uzmanların görüşleri tam olarak örtüşmese de, hepsi bir arada gömülü “beynin” gerçek güncel konumlarını haritalandırdı. Sektördeki erken dönem mücadelelerin donanım ve hareket performansı etrafında şekillenirken, bugün odak noktası bu “beynin” teknolojisine ve ticarileşmesine kayıyor. Dünya modelleri, çevresel değişimleri öngörebilme ve nedensel akıl yürütme potansiyeli sunduğu için hızla endüstrinin merkezine yerleşti ve bu yükseliş, daha önce çoğu gerçek dünya uygulamasını besleyen VLA modellerinin konumuna şüphe saldı. Hatta “VLA öldü” gibi radikal iddialar bile gündeme geldi.
VLA’dan Çok Yollu Bir Geçişiş
Gömülü “beynin” teknolojik yol haritası hızla evrim geçiriyor. VLA modellerinin iki yıllık baskın döneminin ardından sektör artık tek bir yola değil, paralel çoklu yaklaşıma doğru kayıyor. VLA modelleri, kamera görüntüleri ve doğal dil talimatları gibi çok modlu gözlemleri alıp doğrudan çalıştırılabilir robot eylemleri olarak çıktı verir. Bu yaklaşım, “sahneyi gör, komutu anla, eyleme geç” sürecinin tamamını tek bir sinir ağı içinde uç uca öğrenir.
Temelinde bu yöntem, gösterim verisinden devasa miktarda veriyle “gözlem” ile “eylem” arasındaki eşlemeyi öğrenen, taklit öğrenmesine dayalı, uç uca bir veri odaklı stratejidir. Başka bir deyişle VLA, gördüğü ve duyduğu üzerine anlık tepki veren, bir uzmanın o durumda ne yapacağını taklit eden yansıksal bir operatör gibi çalışır.
Modülleri birleştirmeden çalışması sayesinde VLA, daha kısa işleme zincirleri ve daha hızlı tepki süreleri sunarak kenar (edge) dağıtıma daha uyumlu bir avantaj sağlar. Örneğin UBTECH’nin Thinker-VLA’sı, çıkarım maliyetlerini düşürmek amacıyla kenarda çalışacak şekilde tasarlanmıştır.
Ji Haifeng, Ruieman Akıllı Teknoloji (Pekin) Şirketi Çözüm Direktörü
Ancak Ji Haifeng, VLA’nın da sınırları olduğunu belirtti. Ona göre VLA esas olarak eylem dizileri üretir ve fiziksel kısıtlamalara dair bir farkındalığı, bir sonraki anı öngörme yeteneği eksiktir. Bu durum, eğitim dağılımının ötesinde zayıf genelleme anlamına gelir. “VLA, bir hareketi nasıl kararlı bir şekilde gerçekleştireceğini açıklayabilirken, hareketten sonra çevrenin nasıl değişeceğini açıklaymakta zorlanır” diyen uzman, bu eksikliği nedensel akıl yürütme ve uzun vadeli planlama yeteneğinin yetersizliğine bağladı.
Bu da tam olarak dünya modellerinin doğal gücü: bir anın mevcut durumunu ve aday eylemi verildiğinde, dünyanın bir sonraki anı nasıl değişeceğini öngörerek “bunu yaparsam ne olur?” sorusuna cevap veren, bu akıl yürütmeye dayanarak fiziksel dünya ile etkileşime geçmesini sağlayan bir yaklaşımdır.
“Dünyayı Öngörmek” ile “Eylem Karar Vermek” Arasındaki Köprü
Peki “dünyayı öngörmek” ile “eylem karar vermek” tam olarak nasıl gerçekleşiyor? Dünya modeli yaklaşımının tutkulu uygulayıcısı Jijia Vision, bu soruya Dünya Üretim Modeli ve Dünya Eylem Modeli ile cevap veriyor. Dünya Üretim Modeli, verilen bir eylemden sonra dünyanın nasıl değişeceğini öngörürken, Dünya Eylem Modeli tam tersini yapar: mevcut gözlemlerden yola çıkarak uygun bir sonraki eylemi tahmin eder. Üretim ve eylem modelleri bir araya gelerek tam bir kapalı döngü oluşturur.
Jijia Vision, bu mantığa dayanarak iki büyük teknik sistem kurdu: Dünya Üretim Modeli ve Dünya Eylem Modeli. Önci Dünya Üretim Modeli, gömülü zeka için GigaWorld, otonom sürüş için DriveDreamer ve içerik üretimi için YiSu’yı kapsar; sonrakisi ise genel gömülü beyin GigaBrain ve dünya eylem modeli GigaWorld-Policy’dir.
Mao Jiming, Jijia Teknoloji Ortak ve Vice President
2026 Dünya Robot Konferansı’nda Jijia Vision, genel dünya modelleri için L1-L5 sınıflandırma sistemini tanıttı. L1, çeşitli girişlerden görsel olarak gerçekçi genel video dünyaları üretip dünyayı önce “gerçek görünümlü” kılmayı; L2, “geleceği görmek” ile “bir seçim yapmak” arasındaki boşluğu kapatıp verimli ve mantıklı genel eylem üretmeyi; L3, piksel yüzeyinden geometrik bilgi çıkararak geometrik olarak doğru genel uzaysal dünyalar üretmeyi; L4, uzaysal doğruluktan nedensel doğruluğa geçerek fiziksel olarak doğru genel fiziksel dünyalar üretmeyi; L5 ise sürekli geri bildirimle uzun vadede var olabilen, sonsuz genel dünyalar üretmeyi hedefler.
“L1 ve L2, ‘GPT-3 anına’ karşılık gelir. L3 ve L4’e girdiğimizde dünya modellerinin ikinci bir aşamaya evrileceğine inanıyoruz. Bu noktada modeller, akıl yürütme gerektiren yüksek zorlukta, uzun ufuklu görevleri tamamlayabilen ajanları destekleyebilir; bu da mevcut ‘Claude anına’ benzer bir verimlilik sunar ve tam ölçekli ticarileşmenin girişini işaretler” diyen Mao, “Şu anda yakın vadeli kurumsal hedeflerimizi gerçekleştirmek için L1 ve L2’ye odaklanıyoruz” ifadelerini kullandı.
Yeni Bir Paradigma: Yıkama Değil, Yeniden İnşa
Sektör VLA ile dünya modellerinin hangisinin nihai aşamaya daha yakın olduğunu tartışırken hâlâ kilitlenmişken, başka bir grup oyuncu bu seçimi tamamen atlamayı deniyor. Guangxiang Lab’ın Baş Bilim Adamı Lu Yao, “Bence tartışmanın odağı paradigmanın kendisi olmamalı” diyerek, bunun yerine gömülü zekanın gerçek geliştirme ihtiyaçlarına ve bilgi zekası ile arasındaki farklara odaklanılması gerektiğini savundu. “Modelin sonuna bakarak başlamak” felsefesine dayanan bu yaklaşım, gömülü “beynin” mimarisini temelden yeniden inşa etmeyi hedefler.
İnsanların fiziksel dünyada kazandıkları anlayışın ve davranış yeteneğinin yalnızca %10 ila %20’si görsel gözlem ve taklitten gelir; gerçekteki algısal etkileşim ve deneme-yanılma geri bildiriminden gelen büyük çoğunluk vardır. Bu, fiziksel yerleşik zekanın geliştirilmesinin merkezinde duran bir gerçektir.
Zhang Tao, Guangxiang Teknoloji Kurucu ve CEO
Lu’ya göre Guangxiang’ın fiziksel yerleşik zekası, ajan-çevre etkileşiminin geliştirme sürecinin her aşamasında ihtiyaçlarına vurgu yapar. Bu, sistemin dünyayı nasıl değiştiğini ve eylemlerin sonuçlarını anlamasını sağlar; öğrenme sürecinde fiziksel yasaları ve güvenlik kısıtlamalarına uyumayı sürdürürken. Modelin temeli hâlâ dünya modeli olarak kalsa da, fiziksel varlıkların dünya modeli, veri yapısı ve eğitim algoritmaları olmak üzere üç boyutta daha derine inmesi söz konusudur. Bu, fiziksel dünya verisinin kıtlığı, işlevsel güvenliğin daha yüksek gereksinimleri ve model eğitiminde istikrar ile uzun ömürlülüğün peşini içerir.
Son dönemde Tsinghua Üniversitesi’ndeki Li Shengbo Profesörü’nün ekibiyle işbirliği içinde Guangxiang Teknoloji, nesillerine ait ilk fiziksel yerleşik dünya modelini, Phi-WM 1.0 ActEffect’i resmi olarak yayınladı. Raporlara göre model, üç uluslararası robotik manipülasyon benchmark’ında önde gelen puanları elde etti.
Yeni Paradigmalarda bile Temel Dünya Modelleri ve VLA’da Kalıyor
Fiziksel yerleşik zeka yolundan öte, beyni andıran zeka—nöromorfik zeka—diğer bir teknolojik paradigma olarak sektörde dikkat çeker hale geliyor. İnsan beyninin sinir mekanizmalarını ve bilişsel mimarisini ödünç alarak zeki sistemler kuran bu yaklaşım, robotların biyolojik bir beynin katmanlı biçiminde algılayıp, karar verip, yansıyıp ve öğrenmesini sağlar. Önde gelen isimler arasında Junaopanshi ve Zhipingfang yer alır.
Junaopanshi, son dönemde çekirdeği hâlâ bir dünya modeli olan, ancak piksel düzeyinde gelecekteki görüntüleri üretmek yerine soyut bir gizli uzayda çevresel durumları öngören beyni andıran JEPA (Birleşik Eşlemeli Öngörü Mimarisi) yaklaşımını benimseyen ilk nesil bilişsel dünya modelini, Cog-WM 1.0’u yayınladı. Zaman-uzay hafızasını tek bir mimariyi sürükleyen bu yöntem, robotların önceden hazırlanmış haritalar veya devasa veri miktarı olmadan tanıdık olmayan ortamlarda otonom planlama, semantik navigasyon ve manipülasyon yapmasını mümkün kılar.
Cog-WM 1.0, tekerlekli insansı ve dört ayaklı robotlarda haritasız otonom navigasyon ve yol planlaması, zaman-uzay hafızası geri çağırma ve nesne bulma için uzaysal ilişki soru-cevap gibi çekirdek yetenekleri gösterdi. Tekerlekli insansı robotlarda manipülasyon yeteneğini de doğruladı; ancak henüz ticarileşmiş büyük ölçekte dağıtılmadı.
Junaopanshi
Zhipingfang’ın NeuroVLA’sı ise insan beyninin “korteks-serebellum-omurilik” işbirliği mekanizmasını VLA mimarisine getiriyor. Korteks semantik anlama ve görev planlamasıyla ilgilenirken, serebellum yüksek frekanslı hareket koordinasyonunu ve dinamik düzeltmeyi yönetir; omurilik ise milisaniyelik eylem yürütmesi ve güvenlik reflekslerinden sorumludur. Ekim sonlarında Zhipingfang’ın NeuroVLA ile güçlendirilen AlphaBot 2 (Aib


